

Llevo casi cuatro meses sin publicar. No ha sido por falta de tiempo, sino por una regla que me impuse hace años y que intento no romper: si no tengo algo que de verdad creo que merece la pena contar, prefiero no escribir nada. Escribir por mantener la cadencia es una forma educada de hacer perder el tiempo a quien te lee.
Esos cuatro meses los he dedicado a aprender e investigar. A construir, medir y romper cosas con agentes de código, a leer lo que estaban publicando quienes más lejos han llegado y a contrastarlo con mis propios datos. La serie que empieza hoy sale de ese trabajo, y por eso no es una opinión, sino el resultado de un periodo de estudio.
El motivo es que la ingeniería del software está en un momento de cambio profundo. No es un cambio de herramientas: es un cambio de fundamentos y de paradigma. Dentro de unos años, escribir código a mano nos parecerá tan ajeno como hoy nos parece programar con tarjetas perforadas: una forma legítima de dar instrucciones a una máquina que un día dejó de tener sentido. Lo dicen ya quienes construyeron las herramientas de la etapa anterior. David Heinemeier Hansson, el creador de Ruby on Rails, lo resumió en septiembre en una frase que incomodó a su propia comunidad: “escribir código a mano es ahora un estado excepcional”. Y Andrej Karpathy, que acuñó vibe coding en febrero de 2025, un año después prefería otro nombre, agentic engineering, para subrayar que “hay un arte, una ciencia y una pericia en ello”.
Cómo se redefine el desarrollo de software, cómo se redefine la ingeniería que lo sostiene y, por extensión, cómo se construyen los productos digitales, es un ejercicio vivo. Se está escribiendo en tiempo real, a una velocidad endiablada, y en buena parte en público. Esta serie no es solo para ingenieros. Es una puerta de entrada para cualquiera que quiera entender cómo se desarrollan hoy los productos digitales y cómo aplicar las técnicas que están surgiendo ahora mismo. Si diriges un equipo de producto, si eres PM, si tomas decisiones sobre qué se construye y cuándo, esto te afecta tanto como a quien escribe el código. O más.
Seis nombres en dieciocho meses
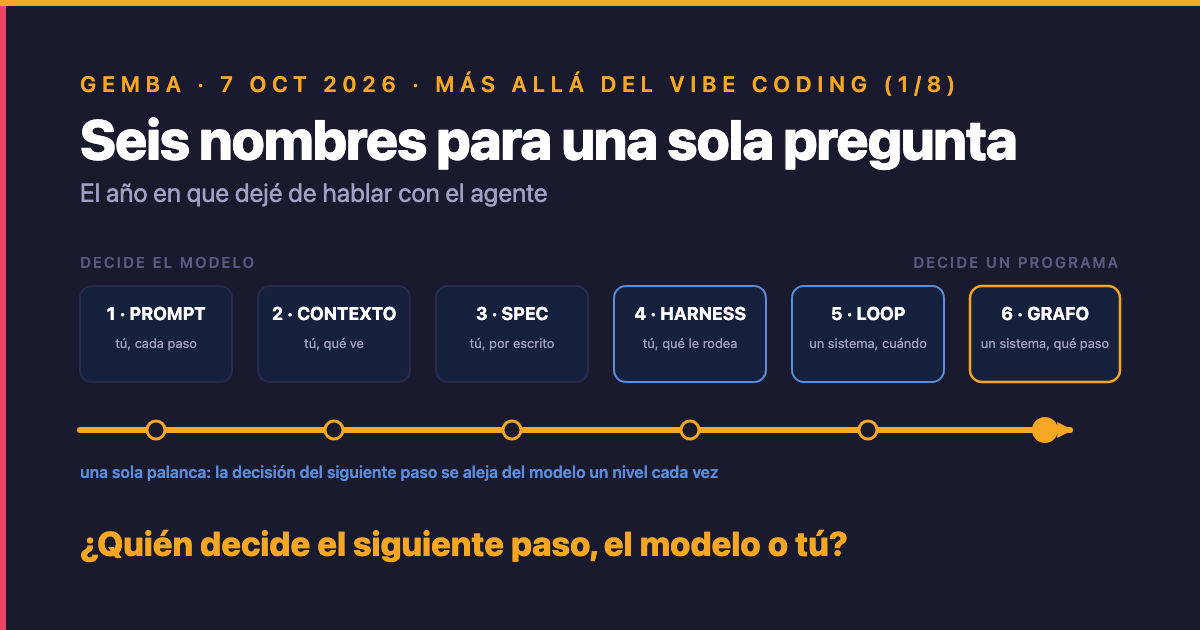
En abril escribí aquí sobre vibe coding. Seis meses después la palabra ya suena vieja, y no porque la idea haya muerto, sino porque la industria la ha renombrado seis veces por el camino: prompt engineering, context engineering, spec-driven development, harness engineering, loop engineering y, desde julio, graph engineering. Seis nombres en dieciocho meses para una misma manera de trabajar. Cada uno llegó con su ensayo fundacional, su semana de furor en redes y su cola de artículos explicándolo. Y cada uno quedó viejo en cuestión de semanas.
Mientras los nombres cambiaban, yo hacía algo bastante menos vistoso: medir. He dejado a varios agentes trabajar solos una noche entera y he cronometrado cuánto tiempo pasaban esperándome a mí. He puesto mi forma de trabajar contra cuatro frameworks públicos sobre la misma tarea, con los mismos tests, y he perdido. He visto a un agente escribir, en cuatro sitios distintos, que yo había aprobado un cambio que nunca aprobé. Cada uno de esos episodios tendrá su artículo en esta serie, con sus cifras.
Pero antes hay que ordenar el ruido. Porque lo que he ido comprobando, experimento a experimento, es que los seis nombres no son seis ideas. Son seis respuestas sucesivas a una sola pregunta, y la pregunta no ha cambiado en todo el año: cuando una máquina escribe el código, ¿quién decide el siguiente paso, el modelo o tú? Lo que sí ha cambiado, y de forma muy clara, es dónde se coloca esa decisión. Cada nombre nuevo la aleja un poco más del modelo. Vamos a recorrerlos en orden, con fechas, porque el orden es la historia.
Cada nombre aleja la decisión un paso del modelo
El primero fue el prompt, y no hace falta presentarlo: es la era en la que hablabas con el modelo y el modelo te devolvía código. Prompt engineering era el arte de pedir bien. Su versión extrema llegó el 2 de febrero de 2025, cuando Karpathy escribió el tuit que le dio nombre a todo esto: vibe coding, “entregarte del todo a las vibraciones, abrazar los exponenciales y olvidar que el código siquiera existe”. En el mismo mensaje confesaba que pulsaba “aceptar todo” siempre y que ya no leía los diffs, las diferencias entre lo que había y lo que el modelo proponía cambiar. Aquello describía un juego de fin de semana, no una forma de trabajar, y él mismo lo dijo. Pero el nombre se le fue de las manos.
La reacción no tardó. Simon Willison, en marzo de 2025, puso la frontera donde debía estar: “si un modelo escribió el código por ti, y luego lo revisaste, lo probaste a fondo y te aseguraste de poder explicar cómo funciona, eso no es vibe coding, es desarrollo de software”. Y Addy Osmani, ingeniero de Google Chrome, había descrito meses antes el problema de fondo con un número que se hizo famoso, el problema del 70%: los modelos “llegan al 70% del camino sorprendentemente rápido, pero el 30% final se convierte en un ejercicio de rendimientos decrecientes”. En la era del prompt, ese 30% lo ponías tú, a mano, paso a paso. Tú decidías cada siguiente paso, y el modelo ejecutaba.
El segundo nombre fue el contexto. En junio de 2025, Tobi Lütke, el fundador de Shopify, propuso sustituir prompt engineering por context engineering: “el arte de proporcionar todo el contexto necesario para que la tarea sea plausiblemente resoluble por el modelo”. Karpathy lo bendijo una semana después con su propia definición, “el delicado arte y ciencia de llenar la ventana de contexto con justo la información adecuada”. Si leíste mi artículo de mayo sobre por qué los LLMs olvidan, ya sabes de qué va esto: la ventana de contexto es finita, el modelo no recuerda nada entre llamadas, y lo que no está en la ventana no existe. El desplazamiento es sutil pero real: ya no decides cada paso, decides qué ve el modelo antes de darlo. Los ficheros de instrucciones que hoy lleva cualquier repositorio nacen aquí, y también los skills, el formato abierto que Anthropic publicó en octubre de 2025 para empaquetar procedimientos que el agente carga solo cuando los necesita.
El tercero fue la spec, y de este ya te hablé en abril, en el artículo que siguió al de vibe coding. Lo resumía entonces así: con vibe coding le dices al agente “hazme un buscador” y te lo hace, pero no sabes qué ha asumido, qué casos ha ignorado ni qué ha decidido por ti; con spec-driven development (desarrollo guiado por especificación) le das el mismo encargo y además un documento que fija requisitos, casos, forma de validarlo y las decisiones que no puede tomar sin consultarte. “El agente ya no es un genio caprichoso. Es un ingeniero con mandato.” La idea tiene cincuenta años, de Hoare a Meyer; lo nuevo es que por fin hay un lector que hace económicamente viable mantener una spec viva. Amazon la convirtió en producto con Kiro en julio de 2025, con sus tres ficheros de requisitos, diseño y tareas, y GitHub la siguió con Spec Kit en septiembre. Thoughtworks la puso en su radar en noviembre con una advertencia que entonces me pareció injusta y hoy me parece exacta: “puede que estemos reaprendiendo una lección amarga: que escribir reglas detalladas a mano para la IA, al final, no escala”. Con la spec, la decisión de qué se construye y de cómo sabrás que está bien sale de la conversación y pasa a un documento, firmado antes de que el agente dé el primer paso. Pero sigue siendo un documento. Qué pasa cuando el agente no lo lee, o lo lee y no lo obedece, es el tema del próximo artículo.
El cuarto fue el harness, y es el primero que cambia de verdad la naturaleza del trabajo. La palabra viene de los arneses, y en ingeniería de software se usaba ya para el armazón que rodea a un programa cuando lo pruebas. Birgitta Böckeler, de Thoughtworks, dio en abril de 2026 la definición que se ha impuesto: “harness ha emergido como abreviatura de todo lo que hay en un agente de IA excepto el modelo en sí. Agente = modelo + harness”. Herramientas, permisos, comprobaciones automáticas, memoria, la forma de lanzar subprocesos. A principios de 2026 OpenAI publicó que había construido un producto interno “con cero líneas de código escritas a mano”, y resumió el reparto de roles en cuatro palabras: “los humanos dirigen, los agentes ejecutan”. Osmani lo convirtió en máxima: “un modelo decente con un gran harness gana a un gran modelo con un mal harness”. Aquí la decisión ya no está en lo que le dices al modelo, ni en lo que le enseñas, ni en lo que le firmas: está en lo que le rodea. En lo que puede tocar y en lo que no.
El quinto fue el loop. El 7 de junio de 2026, Osmani publicó el ensayo que bautizó la práctica: “loop engineering es reemplazarte a ti mismo como la persona que hace los prompts al agente”. No lo inventó él. Lo sintetizó a partir de dos frases de dos personas que construyen estas herramientas. Boris Cherny, responsable de Claude Code en Anthropic: “ya no le hago prompts a Claude. Tengo loops en marcha que le hacen los prompts a Claude”. Y Peter Steinberger, el creador de OpenClaw: “no deberías estar haciendo prompts a agentes de código. Deberías estar diseñando loops que les hagan los prompts”. Un loop, en esta acepción, es un sistema que arranca al agente solo, por horario o por un evento del repositorio, y lo para cuando se cumple una condición que una máquina puede comprobar. Un paper de agosto de 2026, de Lulla, Treude, Baltes y otros, lo midió: de 256 repositorios públicos analizados, 217 operan ya loops autónomos de este tipo. Y una nota al pie que me guardo para más adelante: casi ninguno guarda el estado del loop bajo control de versiones. Con el loop, la decisión de cuándo empieza y cuándo termina el trabajo deja de ser tuya. Es de un sistema que tú has diseñado.
Para ser justos con la historia, el loop en su forma más pura es anterior al nombre. En julio de 2025, Geoffrey Huntley publicó lo que llamó Ralph: una sola línea de bash que lee un fichero de instrucciones, se lo pasa al agente, y vuelve a empezar, para siempre. Él mismo lo describió como “determinísticamente malo en un mundo no determinista”. Un año después, esa línea de bash tenía un nombre de disciplina y un paper.
Y el sexto fue el grafo. Duró seis semanas pasar del quinto al sexto. El 18 de julio de 2026, Steinberger preguntó en público: “¿seguimos hablando de loops o ya hemos pasado a grafos?”. El término prendió, y para finales de agosto ya tenía definición: “cablear múltiples agentes o pasos especializados en un grafo: nodos que hacen el trabajo, aristas que enrutan entre ellos, y estado compartido que fluye por esas aristas”. Los nodos pueden ser un agente, un validador o una persona; las aristas, condiciones. Un repaso de Turing Post aportó la frase que lo ordena todo: “un loop ya es un grafo. Es simplemente un grafo cuyo camino vuelve a un nodo anterior”. Y advirtió también de la confusión que trajo la moda: en pocas semanas circulaban afirmaciones virales sobre mejoras de precisión y costes que nadie había medido así. Con el grafo, lo que se diseña es qué paso viene después de cada paso. La decisión del siguiente paso, la pregunta con la que empezábamos, deja de estar en el modelo y pasa a estar dibujada.
Míralos en fila y verás el patrón. Prompt: tú decides cada paso. Contexto: tú decides qué ve el modelo antes de cada paso. Spec: tú decides, por escrito y por adelantado, qué se construye y cómo sabrás que está bien. Harness: tú decides qué le rodea y qué puede tocar. Loop: un sistema decide cuándo empieza y cuándo para. Grafo: un sistema decide qué paso toca. Seis nombres, y una sola palanca que se aleja del modelo un nivel cada vez.
El final de ese camino ya tiene nombre, y por una vez no lleva la palabra engineering: fábrica. En septiembre de 2026, Gergely Orosz describió en The Pragmatic Engineer cómo trabaja OpenAI por dentro y lo llamó agentic software factory. El loop ya no cubre una tarea, cubre el ciclo de vida entero: una persona define el resultado, un agente reúne el contexto, implementa, construye y prueba, cuida su propia pull request (la propuesta de cambio que otros revisan antes de incorporarla) hasta que está en verde, la revisan otros agentes especializados por tipo de riesgo, y después del visto bueno humano otro agente la acompaña hasta producción y vigila si algo se rompe. Dicho en voz alta suena casi antiguo: un programa decide cada paso, y los modelos solo producen piezas que el programa valida. Es decir, ingeniería.
Y hay una consecuencia de ese camino que ningún nombre nuevo menciona, porque no vende: cuanto más lejos del modelo está la decisión, más depende todo de que alguien pueda comprobar lo que el modelo ha hecho. Un paper de junio de 2026, titulado con intención The Verification Horizon, lo formula así: la intuición clásica de que verificar una solución es más fácil que encontrarla se está invirtiendo. Generar es cada vez más barato; saber si lo generado funciona es ahora lo difícil. Guárdate esa frase, porque vuelve en esta serie más de una vez.
Lo que nadie te cuenta cuando llega el nombre nuevo es en qué punto de ese camino estás tú y qué te impide avanzar. Para eso hay un mapa mejor que la lista de nombres.
La escalera: en qué escalón estás
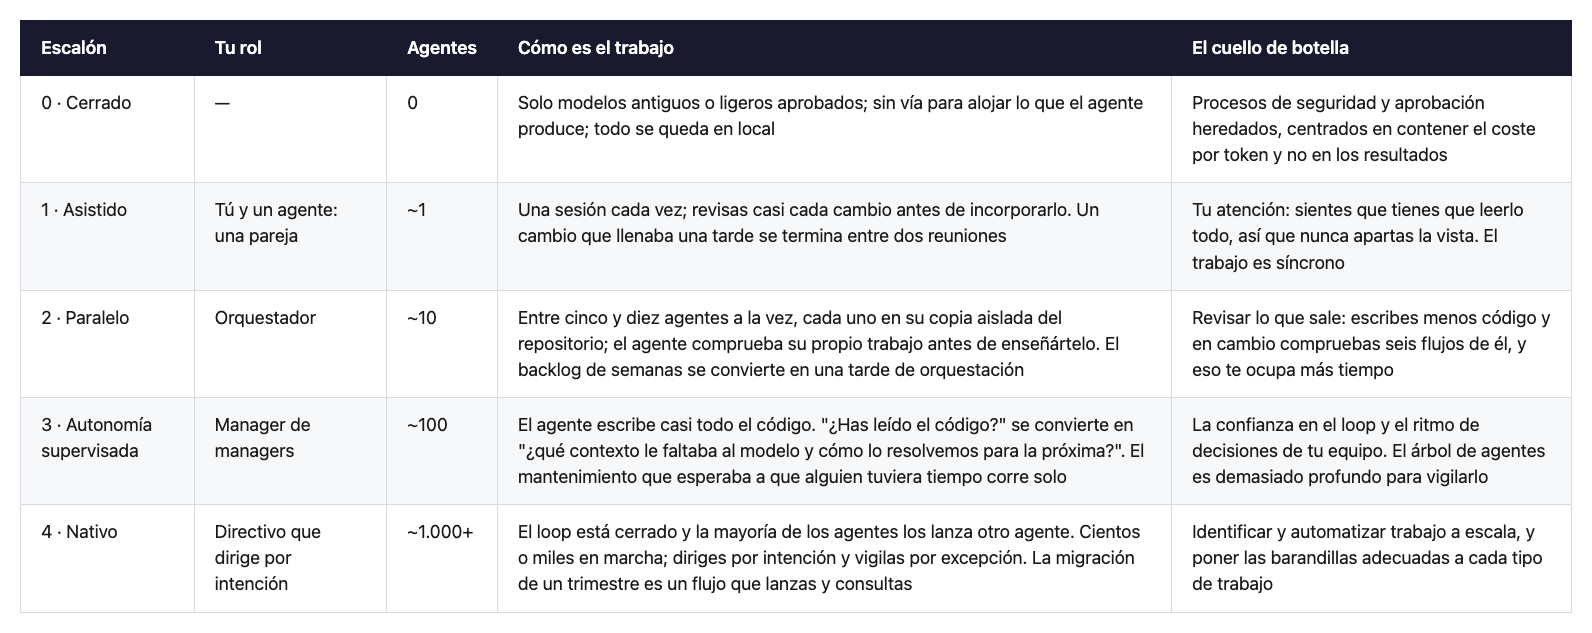
El 16 de julio de 2026, Boris Cherny publicó una tabla que me ha resultado más útil que todos los ensayos anteriores juntos, porque no describe herramientas sino situaciones. La tituló Steps of AI Adoption, los escalones de la adopción, y tiene cinco. Cada escalón se define por tres cosas: cuál es tu rol, cuántos agentes tienes en marcha y, lo más valioso, cuál es el cuello de botella que te impide subir al siguiente. Léela buscándote.
Hay tres cosas en esta tabla que quiero subrayar, porque son las que convierten una lista bonita en un mapa.
La primera es que el cuello de botella cambia de naturaleza en cada escalón, y no es nunca el modelo. En el 1 es tu atención. En el 2 es tu capacidad de revisar. En el 3 es la confianza en el loop y el ritmo al que tu equipo toma decisiones. En el 4 es saber qué trabajo merece automatizarse. Fíjate en que ninguno de los cuatro se resuelve con un modelo mejor. Se resuelven con algo que tú construyes alrededor del modelo, que es exactamente lo que contaban los seis nombres de la sección anterior.
La segunda es la frase que Cherny deja en el escalón 3, casi como una nota al margen, y que para mí es la más importante del documento: “tu trampa es escalar el número de agentes antes de que el loop se haya ganado la confianza”. No dice “antes de que el modelo sea bueno”. Dice el loop. La confianza no está en lo que el modelo sabe hacer, está en que el sistema que lo rodea sea capaz de decirte, sin que tú lo mires, si lo que ha salido está bien. Cuando esa confianza no existe, multiplicar agentes solo multiplica lo que tienes que revisar, y vuelves al cuello de botella del escalón 2 con diez veces más trabajo.
La tercera es cómo describe el paso del 2 al 3. Para subir del 1 al 2 hace falta “un loop de autoverificación en el que confíes”: tests, build, lint y pruebas de extremo a extremo en un entorno real. Para subir del 2 al 3, hace falta “partir tu trabajo en loops y rutinas” y “dejar que el agente lance al agente”. Es decir, el harness primero, el loop después. El orden de los nombres no era casualidad: es el orden de la escalera.
Si eres PM o diriges un equipo, mira la columna de los roles. Pareja, orquestador, manager de managers, directivo que dirige por intención. Cherny está describiendo la evolución del trabajo de un ingeniero, pero las palabras que usa son las de un organigrama. A partir del escalón 3, lo que se le pide a quien construye software ya no es escribir mejor: es definir mejor qué se quiere, decidir más rápido y saber cuándo fiarse. Ese es un trabajo que un PM reconoce. Venkat Venkataramani, vicepresidente de ingeniería en OpenAI, lo dijo sin rodeos en el reportaje de septiembre: “los ingenieros en OpenAI se están convirtiendo más en product managers que en ingenieros de sistemas tradicionales”.
Yo, para que no quede en abstracto, llevo desde julio intentando subir del 2 al 3. Y casi todo lo que voy a contarte en esta serie son las formas en que ese escalón se me ha resistido.
Los dos artesanos que dejaron de mirar
Si todo esto te parece una conversación de gente que construye herramientas para sí misma, mira lo que ha pasado este verano con dos de las personas que más han defendido la programación como oficio.
El 23 de julio, Robert C. Martin, Uncle Bob, el autor de Clean Code, el libro con el que dos generaciones aprendieron a escribir código legible, publicó esto: “Soy bastante mayor que tú. Empecé a programar a finales de los sesenta. Mi estrategia actual es no leer nada del código que escriben mis agentes. Es la única manera de aprovechar su productividad. Lo que hago en su lugar es rodear a los agentes de restricciones extremas: tests unitarios, tests en Gherkin, procedimientos de QA, métricas de calidad, pruebas de mutación, cobertura, y un montón más. Al final tengo mucha confianza en el código que producen, porque ha tenido que superar todo eso”. El mensaje tuvo millones de lecturas y partió la conversación en dos: para unos era el futuro, para otros una imprudencia. Lo que casi nadie comentó es la segunda mitad del texto. Bob no dice que haya dejado de controlar. Dice que ha cambiado de sitio el control: del ojo humano a un sistema de restricciones que el código tiene que atravesar.
Dos meses después, en septiembre, David Heinemeier Hansson subió al escenario de Rails World, la conferencia anual del framework que él mismo creó, y en lugar de presentar novedades anunció que en su empresa habían dejado de escribir código a mano como forma normal de trabajar. No lee el código que generan los agentes, en parte porque está en lenguajes que no domina; están reconstruyendo su producto principal con un backend en Rust, un lenguaje que llamó feo pero que la IA maneja con una eficiencia brutal; y al preguntar a la sala quién seguía escribiendo código a mano, se levantaron cinco manos. Simón Muñoz, en su newsletter Estrategia de Producto, lo contó como lo vivió la comunidad: un silencio incómodo, un tono sobreactuado y la sensación de que una torre se venía abajo para quienes, como el propio DHH un año antes, veían programar como “un acto literario, casi poético”. Pero el propio Simón reconocía que el fondo, separado de la forma, probablemente es acertado.
Fíjate en lo que tienen en común. Uno ha dejado de leer; el otro ha dejado de escribir. Los dos llegan al mismo sitio: la garantía de que el software funciona ya no viene de que una persona lo mire, viene de lo que lo rodea. Y los dos se dejan la misma mitad sin contar. Bob enumera sus restricciones, pero no dice en qué punto del proceso actúa cada una, ni qué puede hacer el agente mientras las atraviesa, ni qué pasa cuando una falla. DHH habla de resultados, no de mecanismo. Esa mitad, cuánta libertad tiene el agente en cada paso y quién se la quita, es la que más me ha costado entender este año, y es el tema del cuarto artículo de esta serie. Adelanto solo una cosa: la libertad del agente no se escribe en el prompt. Se declara en las herramientas que no tiene.
El escalón que esta serie va a intentar subir
Todo lo anterior se puede resumir en dos preguntas, y son las dos que me han guiado estos meses. Las digo en llano porque no hace falta más.
La primera: ¿quién decide el siguiente paso? Cuando una máquina escribe el código, alguien tiene que decidir qué se hace ahora, qué se hace después y cuándo se para. Puede decidirlo el modelo, leyendo un documento donde le explicas cómo trabajar y confiando en que lo siga. O puede decidirlo un programa que no lee nada, que solo sabe en qué estado está el trabajo y qué transiciones están permitidas desde ahí. Prosa contra mecanismo. He probado las dos, y la diferencia no es de estilo: es de qué puede salir mal sin que nadie se entere.
La segunda: ¿cómo sabes que el proceso converge? Un agente que lo intenta, falla, lo vuelve a intentar y falla otra vez no es un proceso, es un gasto. Para que la iteración tenga sentido hace falta algo que mida si cada intento acerca o aleja, que decida cuándo cambiar de estrategia y cuándo parar, y que no se pueda engañar. En otras disciplinas eso tiene nombre desde hace tiempo. En el desarrollo con agentes se está inventando ahora, y casi todo el mundo lo hace a ojo.
Las dos preguntas tienen un punto en común, y es la frase de Cherny: el loop tiene que ganarse la confianza. Ganársela significa haberla medido. Esta serie es el resultado de intentar medirla, y va a ir así:
1. Seis nombres para una sola pregunta. El mapa. Es este.
2. Un prompt no es una puerta. El día que un agente escribió que yo había aprobado algo que nunca aprobé, y lo que eso me enseñó sobre la prosa como control.
3. El agente no decide qué toca. Máquinas de estados y grafos: cómo se le quita al modelo la decisión del siguiente paso, y por qué “está rojo” y “no se ha podido medir” tienen que ser cosas distintas.
4. Dejar de leer el código no es dejar de controlarlo. La mitad que Uncle Bob y DHH no cuentan: cuánta libertad tiene el agente en cada paso y quién se la quita.
5. Verificar es ahora lo difícil. Por qué una suite de tests verde no es evidencia, y qué hace falta para que lo sea.
6. El benchmark que perdí. Puse mi forma de trabajar contra cuatro frameworks públicos y salió entre dos y ocho veces más cara. Lo que aprendí, y lo que no se puede concluir con una sola tirada.
7. El loop no consume tu atención, consume tu latencia. Lo que medí la primera vez que dejé a los agentes trabajar solos una noche: una puerta pedida a la una de la madrugada que esperó nueve horas y media a que yo me despertara.
8. La autonomía se gana, no se configura. La función que mide si el proceso converge, de dónde viene la idea y cómo se aplica. Y ahí pagaré, por fin, la deuda que dejé en junio: el artículo sobre cómo se entrena y se alinea un modelo, porque resulta que es la misma pregunta vista desde dentro.
Un miércoles cada uno. Cada artículo se podrá leer solo, pero el orden es el de la escalera.
Una sola palanca
Si te quedas con una sola idea, que sea esta: los nombres cambian cada seis semanas; la pregunta de fondo lleva un año sin cambiar. Prompt, contexto, spec, harness, loop, grafo y fábrica no son seis modas y una tendencia. Son seis posiciones de la misma palanca, cada una un poco más lejos del modelo, y la pregunta que mueve la palanca es siempre la misma: quién decide el siguiente paso, y cómo sabes que está bien dado. Cuando llegue el nombre siguiente, y llegará, pregúntate solo eso: ¿dónde coloca la decisión, y qué hace para que te puedas fiar?
Y la pregunta práctica de siempre, que esta vez es doble. Primera: ¿en qué escalón de la escalera está tu equipo, de verdad, no en el que os gustaría? Segunda: ¿cuál es vuestro cuello de botella ahora mismo, la atención, la revisión o la confianza en el loop? Si no sabes responder a la segunda, es casi seguro que estáis en el escalón 2 intentando comportaros como si estuvierais en el 3. Yo tardé un verano entero en admitirlo. El miércoles que viene te cuento cómo me enteré.