

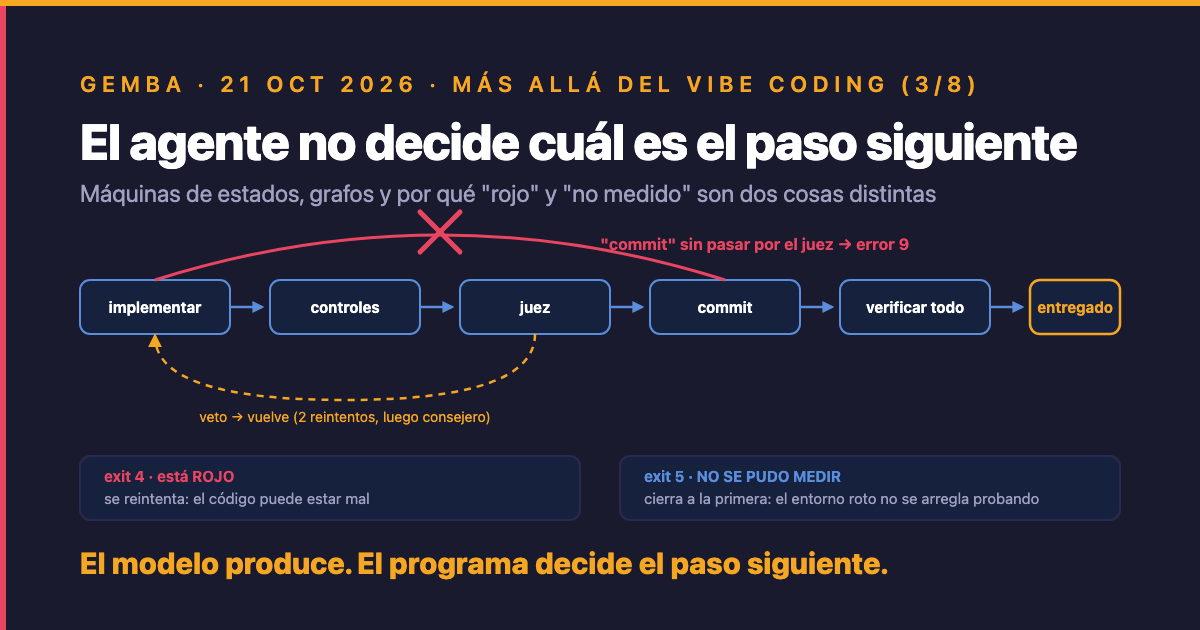
Hay un código de error en mi loop que es mi favorito. Es el 9, y significa exactamente esto: “has pedido un paso que no es el que toca”.
Durante los primeros meses, el agente decidía el orden. Leía un procedimiento escrito en prosa, el mismo que leería una persona, y a partir de ahí resolvía que tocaba implementar, luego probar, luego pedir revisión, luego guardar. Llevaba la cuenta de por dónde iba en un fichero que escribía él mismo. Funcionaba, hasta que dejaba de funcionar: una compactación de contexto y el fichero decía una cosa mientras el agente creía otra; un test que no se había podido ejecutar contado como superado; un “ya está revisado” que nadie podía distinguir de “nadie lo ha abierto”.
En agosto le quité esa decisión. Desde entonces el agente no decide qué toca: pregunta. Un programa de unas quinientas líneas, sin ningún modelo dentro, que no lee ficheros ni consulta la hora, le responde con el siguiente paso. Y si el agente pide un paso que no es el que toca, el programa se niega. Error 9.
Parece poca cosa. Es la diferencia entre un agente con un manual y una máquina.
Dos minutos de teoría: qué es una máquina de estados
Antes de seguir, conviene que tengamos la misma imagen en la cabeza, porque voy a usar la expresión todo el artículo y no es jerga: es una de las ideas más viejas y más simples de la informática.
Una máquina de estados es un sistema que, en cada momento, está en exactamente un estado de una lista cerrada, y que solo cambia de estado cuando ocurre algo de una lista también cerrada de sucesos. Un semáforo es el ejemplo de manual: tres estados, verde, ámbar y rojo; un suceso, “ha pasado el tiempo”; y una regla que dice a qué estado se va desde cada uno. El semáforo no puede estar en dos colores a la vez, no puede pasar de verde a rojo sin pasar por ámbar, y no tiene ninguna opinión sobre el tráfico. Un torno de metro es otro: bloqueado o libre; los sucesos son “moneda” y “empujón”; y la tabla dice que un empujón sobre un torno bloqueado no hace nada, que es precisamente lo que quieres.
Formalmente, una máquina de estados finitos se define con cinco cosas, y las cinco van a aparecer en este artículo con otros nombres: una lista cerrada de estados; una lista cerrada de sucesos que pueden ocurrir; una tabla de transiciones que, para cada pareja de estado y suceso, dice cuál es el estado siguiente; un estado inicial; y un conjunto de estados finales, en los que la máquina se para. Nada más. Lo que hace potente a la idea no es la complejidad sino lo contrario: con la lista de estados y la tabla delante, cualquiera puede verificar qué puede pasar y qué no, sin ejecutar nada.
Traducido a mi loop: los estados son los pasos (implementar, comprobar, juzgar, guardar, y unos pocos más); los sucesos son los resultados de cada paso (hecho, fallado, no medible, descartado); la tabla de transiciones es el programa que responde al agente; el estado inicial es “implementar la primera tarea”; y los estados finales son las formas de terminar, entregado o bloqueado por alguna razón concreta. El agente nunca toca la tabla. Solo produce sucesos. Y cuando pide un paso que no es el estado en el que la máquina está, recibe el error 9, que en términos de semáforo sería un coche pidiendo que el rojo pase directamente a verde.
Con eso basta. Todo lo que sigue es ver qué pasa cuando aplicas esta idea de setenta años a un modelo que, si le dejas, prefiere decidir él.
Quién decidía antes
Conviene ser preciso sobre lo que había, porque es lo que tiene casi todo el mundo hoy y no está mal: está incompleto.
El procedimiento que seguía el agente era un texto de unas cuantas páginas, el mismo tipo de procedimiento que distribuyen los frameworks que cité la semana pasada. Decía, en orden: entiende la tarea, escribe el test que falla, escribe el código que lo hace pasar, pide una revisión a otro agente, incorpora lo que te diga, guarda el cambio, pasa a la siguiente tarea. Es un buen procedimiento. Yo lo seguiría. El problema no era el contenido, era quién lo ejecutaba y dónde quedaba apuntado por dónde iba.
Lo ejecutaba el propio modelo, leyéndolo. Y la posición, el “voy por la tarea tres, pendiente de revisión”, vivía en un fichero de notas que el modelo escribía al terminar cada paso. Esa combinación tiene tres agujeros que descubrí uno a uno.
El primero es la compactación. Cuando una sesión larga se queda sin ventana de contexto, la herramienta resume lo anterior y sigue. En ese resumen, el procedimiento de siete pasos puede quedar en una línea, y el “voy por la tarea tres” puede desaparecer. He visto a un agente, después de compactar, volver a empezar una tarea que ya había terminado, convencido de que era la siguiente.
El segundo es que quien mide es quien ejecuta. El paso “comprueba que los tests pasan” lo hacía el mismo agente que acababa de escribir el código. Cuando los tests no se podían ejecutar, porque faltaba una dependencia o el entorno no arrancaba, el agente tenía que decidir qué anotar, y lo que anotaba era, con una frecuencia que me sorprendió, “verde”. No por mentir: porque “no he podido medirlo” no era una casilla del procedimiento.
El tercero es que la revisión devolvía prosa. El agente revisor escribía un párrafo, el agente implementador lo leía y decidía si lo que decía era un veto o una sugerencia. Un “esto está bien, aunque yo cambiaría el nombre de la función” podía bloquear una tarea o podía ignorarse, y dependía del humor del que lo leyera.
Cuando ordené las diferencias entre ese mundo y el que tengo ahora, me salió esta tabla. Es la que mejor resume de qué va este artículo.
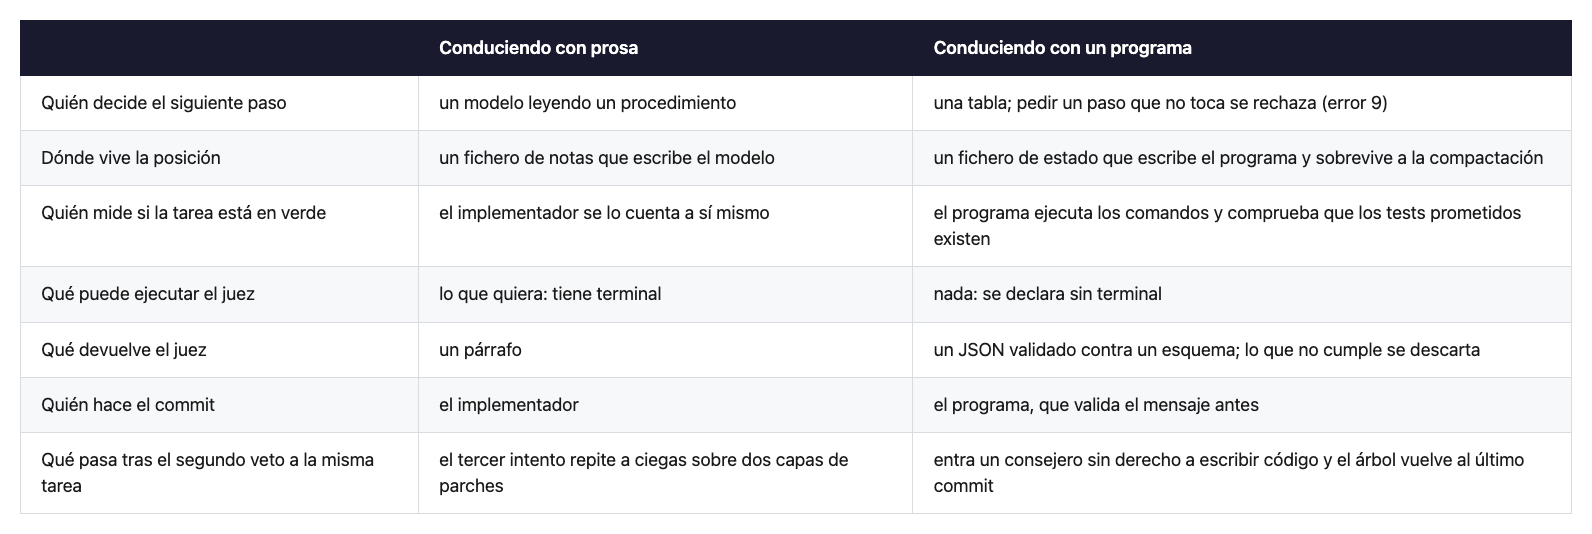
Cada fila de la derecha es una decisión que le quité al modelo. Ninguna le quita capacidad para escribir código. Todas le quitan capacidad para contarse a sí mismo cómo va.
Una tabla que no sabe nada
El programa que responde al agente es, en esencia, una tabla. Dado el paso en el que estás y el resultado que acaba de producirse, la tabla dice cuál es el siguiente paso. Nada más. Y la propiedad que la convierte en una máquina es que es una función pura: no importa ningún módulo, no lee ningún fichero, no consulta la hora. Mismo estado y mismo resultado, misma decisión, siempre. No hace falta un modelo para tomarla, y por eso no la toma un modelo.
Los pasos son ocho: implementar, comprobar los controles, juzgar, aconsejar, guardar, reconciliar con la rama base, verificar el conjunto y juzgar el conjunto. Los resultados posibles de cada paso también son pocos: hecho, fallado, no medible, correcciones pedidas, descartado, presupuesto agotado. La tabla cruza unos con otros y en cada cruce hay una decisión escrita. Y aquí está el detalle que más me costó entender como valioso: los cruces que la tabla no describe lanzan un error ruidoso. No hay un “por defecto, sigue”. Si aparece una combinación que nadie previó, el programa se para y lo dice, en vez de tomar una decisión silenciosa por omisión. Un fallo que grita es una pregunta de diseño pendiente; un fallo que calla es un bug que vas a encontrar en producción.
La posición, el “vas por la tarea tres, pendiente del juez”, ya no la escribe el modelo. La escribe el programa en un fichero de estado al aplicar cada paso, y ese fichero sobrevive a cualquier compactación de contexto porque el modelo no lo tiene que recordar: lo lee el programa cuando el agente vuelve a preguntar.
Dentro de la tabla hay dos ideas que merecen explicarse porque son donde está la ingeniería, no la fontanería.
La primera son los presupuestos. Cada tarea tiene dos reintentos de controles, dos de juez y dos de correcciones, y se reinician al pasar a la siguiente tarea. Hay un tope de seis descartes por slice, que no se reinicia: un descarte es un informe o un veredicto que llega con un formato que no cumple el esquema, y no gasta un reintento porque el código no se ha tocado, pero tampoco puede repetirse para siempre. Y por encima de todo está el dinero: un tope en dólares por slice que corta cualquier otra regla. La frase literal de la tabla es “el dinero corta por encima de todo lo demás”. No porque el coste sea lo más importante, sino porque es el único límite que no depende de que el modelo coopere.
La segunda es el consejero. Cuando el juez veta una tarea, el implementador vuelve a intentarlo con el veredicto delante; es lo razonable, porque la corrección suele ser local. Cuando la veta por segunda vez, la tabla hace algo distinto: antes del tercer intento entra un agente de un nivel superior, que no puede ejecutar nada ni escribir código, mira los dos intentos y los dos vetos, y dicta un enfoque. El programa devuelve el árbol de ficheros al último commit bueno y el tercer intento arranca con ese enfoque en el encargo. El razonamiento que quedó escrito en la tabla es que el tercer intento sin consejero “parchea dos capas de parches”: repetir la misma estrategia a ciegas no converge, cambia de estrategia o para. Ese consejero no tiene contador propio. El reintento que ocupa ya lo gastó el veto que lo abrió.
Nada de esto es nuevo ni original, y conviene decirlo. Las máquinas de estados finitos tienen más de setenta años y están en cada protocolo de red, cada compilador y cada semáforo. Lo que ha cambiado es quién las necesita: hasta ahora servían para acotar programas; ahora sirven para acotar a un modelo que, si le dejas, se acota a sí mismo con prosa. Y se mejoran como siempre se han mejorado: cada incidente es un cruce de la tabla que no estaba escrito. Los dos pasos finales de la mía, verificar el conjunto y juzgar el slice entero, no estaban el primer día; aparecieron cuando descubrí que nadie los ejecutaba y nadie los echaba de menos.
Rojo o no medido
Si tuviera que elegir una sola decisión de diseño de toda la máquina, elegiría esta: “está rojo” y “no se ha podido medir” son códigos distintos.
El programa responde al agente con un código de salida, y la lista de códigos es la gramática de todo el sistema. El 0 es “paso aplicado, pregunta cuál toca ahora”. El 1 es “el juez veta y se acabaron los reintentos”. El 4 es “los controles siguen rojos después de reintentar”. Y el 5 es “los controles no se han podido medir”. Rojo y no medido. Dos números. Lo mismo con el juez: el 3 no significa “el juez dijo que no”, significa “no tengo un veredicto en el que confiar”, porque todos los que llegaron se descartaron por no cumplir el esquema. Y lo mismo con la verificación del conjunto, que tiene sus propios códigos, el 11 y el 12, porque lo que viene después no es “corrige la tarea” sino “no abras el pull request”.
Parece burocracia. Es lo contrario. Es lo que hace que el sistema no pueda fingir que verificó algo. En el mundo de la prosa, “no he podido ejecutar los tests” se convertía en “verde” porque no había otra casilla. Aquí hay casilla, y además cambia lo que pasa después: un control que falla se reintenta, porque el código puede estar mal; un control que no se pudo medir cierra la tarea a la primera, sin gastar los dos reintentos, porque reintentar a ciegas repite el coste sin cambiar nada. El entorno roto no se arregla probando otra vez.
Hay una consecuencia de esto que llega hasta la persona. Cuando un slice se cierra, el estado final no es “entregado” o “fallido”: es uno de nueve. Entregado, bloqueado por controles, bloqueado por el juez, bloqueado por el commit, bloqueado por la verificación global, bloqueado por la reconciliación, bloqueado por las pruebas de extremo a extremo, abortado por presupuesto, bloqueado por una llamada que no respondió. Cada uno dice qué hacer a continuación, y ninguno se parece a los otros. Un sistema que te dice “ha fallado” te obliga a investigar. Un sistema que te dice “no se pudo medir la verificación global porque el contenedor no arrancó” te dice dónde mirar.
Birgitta Böckeler, en su ensayo de abril sobre harnesses, distingue dos tipos de sensores alrededor de un agente: los computacionales, “deterministas y rápidos, como tests, linters y comprobadores de tipos”, y los inferenciales, donde un modelo juzga. Los códigos de salida son la forma de que los dos tipos hablen el mismo idioma: un sensor que no pudo medir no es un sensor que midió cero, y la máquina tiene que saber la diferencia para decidir el siguiente paso.
El grosor de cada estado
Hasta aquí he hablado de las transiciones: qué paso viene después de cuál. Pero una máquina de estados tiene una segunda decisión de diseño, menos visible y más importante: cuánto decide el modelo dentro de cada estado. Lo llamo el grosor del estado, y es un dial.
En un extremo, estados muy finos: una llamada al modelo por cada acción mínima, escribe este fichero, ejecuta este comando, lee este resultado. Lo controlas todo y no sirve para nada, porque cada transición cuesta contexto y tiempo. En mi loop, cada entrada en un estado le cuesta al agente entre 46 y 70 kilobytes de encargo, reglas y convenciones. Con estados de diez segundos, la máquina se pasa el día cargando el encargo y el agente no llega nunca a pensar. En el otro extremo, un estado muy grueso: “implementa el slice entero y avísame”. Barato por transición, y vuelves al artículo anterior, porque todo lo que pasa dentro lo decide el modelo sin que nadie lo vea, incluida la aprobación que se escribe a sí mismo.
Lo que define el interior de un estado son tres cosas, y con eso basta para diseñarlo: qué recibe el modelo al entrar, qué puede tocar mientras está dentro, y cuándo se considera que ha salido. Entre esas tres, libertad completa. La instrucción al implementador de mi loop lo dice así: “escribe el código más pequeño que haga verdadera la tarea; los cuerpos se escriben con el compilador delante; ejecuta lo que necesites para convencerte”. No le digo cómo. Le digo con qué entra, qué puede tocar y qué tiene que ser verdad al salir. El programa decide entre estados; el modelo decide dentro.
Esto tiene nombre en otra disciplina. En una nota de mi diario de agosto lo escribí como regla: determinismo en los invariantes, no en la implementación. Mismo input, mismo comportamiento; no necesariamente el mismo código. Una máquina que intentara fijar también el código no sería una máquina, sería un programador escribiendo con las manos de otro, y para eso ya está escribir uno mismo. La guía de Anthropic para escribir skills usa la expresión exacta, “grados de libertad”, y la regla que da es la misma: ajusta el nivel de especificidad a la fragilidad y variabilidad de la tarea. Donde un error es caro y la forma correcta es una sola, estado fino. Donde hay muchas formas válidas de hacerlo bien, estado grueso.
El dial se puede medir, y lo medí. En septiembre puse dos grosores a competir sobre la misma tarea, con 35 requisitos ocultos que ningún agente había visto. El grosor fino era un plan prescriptivo: varias tareas por slice, cada una con sus ficheros, su contrato y sus comandos de verificación, escritas antes de empezar. El grosor grueso era una sola tarea por criterio de aceptación: el criterio como encargo, y dentro, libertad. Los dos cumplieron los 35 requisitos. El fino costó 117 dólares; el grueso, 97. Y la fase de planificación, que es donde el fino gasta su ventaja, costó 18,51 dólares frente a 7,40. Fue una sola repetición, y así lo anoté: una señal, no una conclusión. Pero la señal era clara y en esa dirección cambié el diseño: la tarea pasó a ser el criterio de aceptación. El estado se hizo más grueso porque el plan detallado no compraba calidad, solo compraba sensación de control.
Hay una lección más en el grosor, y es la que une este artículo con el anterior. Un estado demasiado grueso es donde cabe una aprobación fabricada: si “implementa y espera el OK” es un solo estado, el modelo puede dar el OK por recibido sin salir de él. Un estado demasiado fino es donde el coste por transición se come la ventaja de tener agentes. Entre los dos no hay un número correcto: hay una pregunta que se responde con datos, por tarea, y que cambia cuando el modelo mejora. El dial de hoy no es el dial del año que viene.
El registro que no se puede reordenar
Hay una pregunta que una máquina de estados tiene que responder antes que ninguna otra, y es tan básica que se olvida: ¿cómo sabe la máquina en qué estado está?
La respuesta de mi primer loop era “lo apunta en un fichero”. Mejor que la prosa del modelo, pero con la misma debilidad de fondo: el fichero es una afirmación. Dice “estás en el paso de juzgar”, y si alguien, un proceso, un agente, una persona con prisa, lo edita, la máquina se lo cree. En octubre empecé una segunda versión del loop, en Rust esta vez, con una idea distinta que creo que es la correcta: el estado no se recuerda; se deduce.
Funciona así. Hay siete estados cerrados, en un orden fijo: arrancado, espacio de trabajo preparado, tests congelados, implementado, publicado, propuesto, entregado. Cada operación del programa escribe dos líneas en un registro de solo añadir: una “voy a” antes de empezar, y una “hecho” al terminar. Nunca se edita una línea ya escrita. Y el estado actual no está guardado en ningún sitio: cuando el programa arranca, lee el registro desde el principio y lo reconstruye. Si encuentra un “hecho” que no corresponde al estado al que debería seguir, por ejemplo un “implementado” sin un “tests congelados” antes, no intenta arreglarlo. Devuelve un error con la posición exacta de la línea que rompe el orden, y se para.
Cada línea lleva además el hash de la anterior: una huella criptográfica calculada sobre la línea previa y el contenido de la actual, encadenadas. Si alguien reescribe una línea del medio, todas las siguientes dejan de cuadrar. No es un mecanismo de seguridad contra atacantes; es un mecanismo de honestidad contra el propio sistema. Un registro así no puede “quedar en un estado raro”: o se lee entero y cuadra, o se sabe exactamente en qué línea dejó de cuadrar.
¿Por qué tanto cuidado con algo tan aburrido como un fichero de registro? Por un dato que me dejó pensando. El paper de agosto sobre loop engineering que cité en el primer artículo analizó 36.710 repositorios públicos y encontró 256 que operan loops de agentes autónomos, de los cuales 217 lo confirman de forma inequívoca. Y añade una frase seca: casi ninguno guarda el estado de ejecución bajo control de versiones, en contra de lo que la propia literatura recomienda. Es decir, cientos de equipos tienen ya agentes que trabajan solos durante horas, y casi ninguno puede responder con certeza a la pregunta de en qué estado estaba el loop cuando algo salió mal. El estado vive en la memoria del modelo o en un fichero que el modelo escribe. Es el problema del primer artículo de esta serie, el de la prosa, trasladado a la pieza más crítica de la máquina.
Y aquí es donde este artículo se encuentra con el vocabulario de moda. En julio, cuando Peter Steinberger preguntó si seguíamos hablando de loops o ya habíamos pasado a grafos, lo que estaba nombrando era exactamente esto. Un grafo con nodos que hacen el trabajo, aristas que enrutan entre ellos y un estado compartido que fluye por las aristas. Turing Post lo resumió con una frase que ya cité y que ahora puedo completar: un loop ya es un grafo, simplemente uno cuyo camino vuelve a un nodo anterior. Pues bien, una máquina de estados es un grafo que se niega a saltarse un nodo. Las aristas son las transiciones permitidas; los nodos son los estados con su grosor; y el error 9 es lo que pasa cuando el modelo intenta ir por donde no hay arista. Los flujos de trabajo que Kiro añadió hace un mes, con cada paso en su propia sesión, son esto. El sistema de ejecución determinista de nWave, que bloquea escrituras fuera de fase, es esto. Anthropic lo había dicho en diciembre de 2024, antes de que nadie pusiera nombres: distinguía entre workflows, “sistemas donde los modelos y las herramientas se orquestan a través de rutas de código predefinidas”, y agents, “sistemas donde los modelos dirigen dinámicamente sus propios procesos”, y añadía que las implementaciones más exitosas que habían visto no usaban frameworks complejos sino “patrones simples y componibles”. Año y medio después, la industria ha llegado al mismo sitio por el camino largo: la ruta la decide el código, el nodo lo rellena el modelo.
El modelo produce, el programa decide
Si te quedas con una sola idea, que sea esta: el modelo produce; el programa decide qué toca. Una máquina de estados no le quita inteligencia al agente, le quita una sola cosa: la capacidad de decidir cuál es el siguiente paso y de contarse a sí mismo cómo va. Todo lo demás, el código, los tests, las soluciones, sigue siendo suyo.
Diseñar una te obliga a responder tres preguntas que, en prosa, nunca se responden del todo:
1. ¿Cuáles son los estados, y son cerrados? Si la lista puede crecer sola, no es una máquina. Si una combinación no prevista sigue adelante por defecto, tampoco.
2. ¿Cuánto decide el modelo dentro de cada estado? Con qué entra, qué puede tocar, qué tiene que ser verdad al salir. Y la respuesta se mide, por tarea, con datos, no se decide una vez.
3. ¿Qué pasa cuando algo no se puede medir? Si “no medido” y “rojo” son el mismo resultado, la máquina va a mentir sin querer, y lo hará en el momento en que más confíes en ella.
Para que no se quede en teoría, he publicado un repositorio mínimo con una máquina de estados pura en Python, de unas doscientas líneas: una tabla de transiciones con presupuestos de reintentos, códigos de salida que distinguen rojo de no medido, el registro de solo añadir con hash encadenado, y tests que recorren todos los cruces de la tabla, incluidos los imposibles, sin tocar disco ni lanzar ningún modelo. No sirve para nada por sí sola. Sirve para que veas, en diez minutos, cuánto de lo que hoy confías a la prosa cabe en una tabla.
La semana que viene entro en la otra mitad del grosor: no cuánto decide el modelo dentro del estado, sino quién le quita la libertad y con qué. Un juez que no puede ejecutar nada, un consejero que no puede escribir código, un implementador cuyo modelo lo fija el programa. Lo que Uncle Bob y DHH no cuentan cuando dicen que han dejado de leer el código.
Y la pregunta práctica de siempre. En tu equipo, cuando un agente está a mitad de un trabajo, ¿quién decide cuál es el siguiente paso, él o algo que no es él? Y la segunda, que es la que duele: ¿dónde está apuntado por dónde va, y qué pasa con esa anotación si la sesión se reinicia ahora mismo?
El repo: gemba-state-machine, MIT. La máquina pura, los códigos de salida, el registro encadenado y los tests de los cruces imposibles.